没有独显,本地大模型能跑吗?i5-12400 实测
很多人以为本地跑大模型必须有好显卡。这台机器没有独显,只有 6 核 CPU、32GB 内存和一块核显,我把已装的三个模型都跑了一遍。结论先给:能跑,但要挑模型。
一、结论先说
| 模型 | 体积 | 冷启动 | 生成速度 | 内存占用 | 中文问答表现 |
|---|---|---|---|---|---|
| qwen2.5 3B | 1.9 GB | 2.3 秒 | 17 tok/s | 约 2.5 GB | 快,但事实容易错 |
| qwen2.5 7B | 4.7 GB | 5.1 秒 | 7.8 tok/s | 约 5.3 GB | 质量明显好,慢一倍 |
| deepseek-coder 6.7B | 3.8 GB | 8.3 秒 | 9.2 tok/s | 约 11.4 GB | 通用问答会拒答 |
三个模型都是纯 CPU 推理:接口返回的显存占用是 0 GB,全部吃内存。
图 1:三个模型的生成速度与内存占用,数据取自同一台机器的实测
二、怎么测的
- 环境:i5-12400(6 核 12 线程)、32GB 内存、Intel UHD 730 核显、Ollama 0.40.13
- 方法:同一个问题、温度 0.2、生成上限 80 token;每个模型先卸载再加载,记录加载耗时和生成速度,同时采样系统可用内存变化
- 问题:「用三句话说明魔方层先法的步骤。」 选它是因为答案对错一眼能看出来
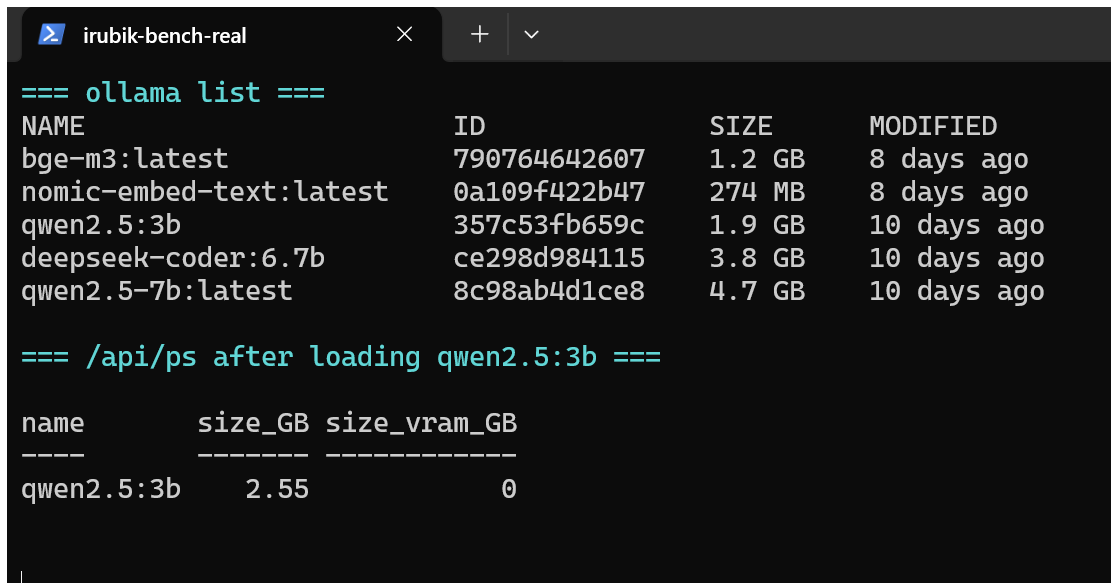
图 2:终端实录。/api/ps 里 size_vram_GB = 0,说明模型全部在 CPU 和内存里跑;size_GB 2.55 与上表的「约 2.5 GB」对得上
三、三个模型的实际表现
3B:快,但事实会错
冷启动 2.3 秒,生成速度 17 tok/s,回答 80 token 只要几秒。但它的原话是「先完成顶层的十字架」——层先法是先做底层十字,第一步就说反了。
7B:慢一倍,质量明显好
内存吃到 5.3GB,速度掉到 7.8 tok/s。它的回答把层先法称为「CFOP 法」——名称错了,但四步顺序基本正确。这说明它知道流程,只是术语混淆。
代码模型:别拿它做通用问答
加载要 8.3 秒,内存吃掉 11.4GB,然后直接拒答:「对不起,我只能回答计算机科学相关的问题……这超出了我的专业范围。」专业模型有领域限制,问它通用问题只会浪费时间。
四、三个值得注意的发现
- 内存占用不等于模型体积:3B 体积 1.9GB、常驻约 2.5GB;7B 体积 4.7GB、常驻约 5.3GB;而代码模型体积只有 3.8GB,却吃了 11.4GB。分配策略不同,选模型要按内存留余量。
- 速度差距不是线性的:3B 是 17 tok/s,7B 只有 7.8 tok/s,慢了一倍多。同样 80 token 的回答,一个几秒、一个十几秒。
- 小模型会非常自信地答错:两个模型都错了,但语气都很肯定,不会说"我不确定"。这是本地小模型最需要警惕的地方——答案对不对,要自己核。
五、没有独显该怎么选
- 日常问答、摘要、改错字:3B 够用,响应快
- 需要准确的术语和事实:7B 起步,但仍然要人工核对
- 代码任务:专用模型可以,但别拿它问通用问题
- 长文生成:按 16 tok/s 算,一千字要一分多钟,能接受就用
- 内存:至少留出模型体积 1.5 倍的空间,否则会被系统换页拖慢
六、想自己复现
看已装模型:
ollama list测一次生成速度(关键看返回里的 eval_count 和 eval_duration):
curl http://127.0.0.1:11434/api/generate -d "{\"model\":\"qwen2.5:3b\",\"prompt\":\"用三句话说明魔方层先法的步骤。\",\"stream\":false,\"options\":{\"num_predict\":80}}"速度 = eval_count ÷ (eval_duration ÷ 10⁹),单位 tok/s。
本文的原始数据存在 editor\logs\bench-*.json 里(含每个模型的 eval_count、eval_duration、内存采样),上面两张图就是从这份数据生成的,可以自己核对。
七、局限
单机、单次、单一问题、温度固定,也没有独显机器做对照;内存测量会受后台程序影响。这些数字只能当量级参考,不同机器会有差别。同一台机器换个模型,结论可能就不一样。